
 日本語
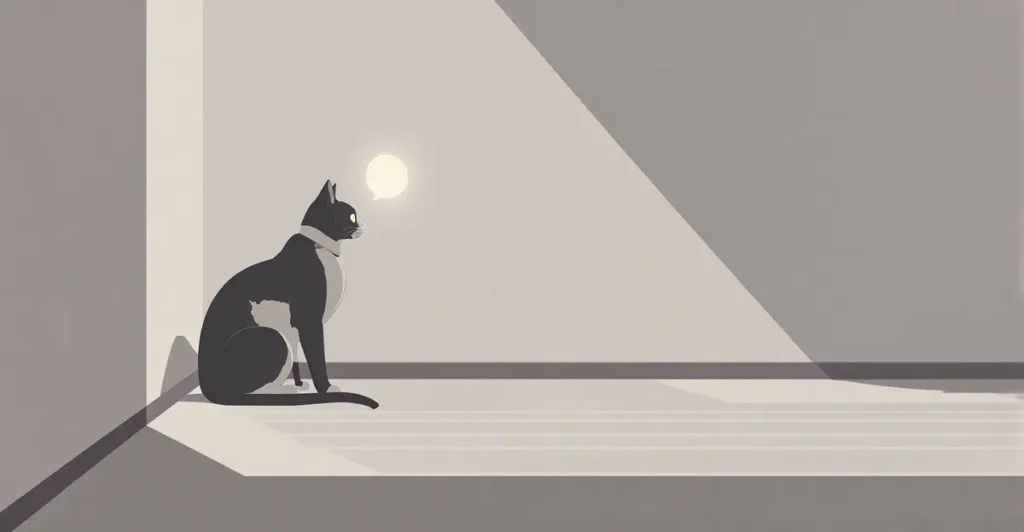
猫は何もない隅を、並外れた確信で見つめられます。チャットボットにも似たことができます。ただし、三段落と参考文献つきです。怖いのは、まともな答えにどれほどよく似ているかです。
AIのハルシネーションは、回答を生成する中で示される、誤った、あるいは裏づけのない出力です。洗練され、具体的で、説得力もあり得ます。理解することはAIを拒むことではなく、どこに立派な文章以上の根拠が必要かを知ることです。
何がハルシネーションに当たる?
どこでも共通の分類はありません。NISTの生成AIリスクプロファイルは、誤った内容に「作話」を用い、入力から外れる答えや、以前の発言と矛盾する答えも含めます。存在しない引用、誤った日付、元にない主張を足す要約などが典型です。
どこかの誤情報をコピーしたとは限りません。新しい誤りを組み立てることもあります。「学習データにないもの」という定義でもありません。正しい推論は新しくてもよく、多く記録された俗説は、やはり誤りかもしれません。
自信は誤りを気づきにくくしますが、ぼかした言い方でも誤りは正しくなりません。「おそらく」の後に架空の論文を出しても、架空の論文であることは変わりません。
流暢な答えが間違う理由
LLMの仕組みのガイド(英語)で説明するように、言語モデルは学んだパターンでトークン列を生成します。NISTは、それが正確な文も、不整合や不正確な文も生むと指摘します。流暢さは、内蔵された真実の証明書ではありません。
学習と評価も関係します。2026年4月にNatureで公表された研究は、正答率中心の採点が、不確かさを認めるより推測を報いる仕組みを検討しています。誤答も正直な回答辞退も零点なら、推測には得点の可能性があります。著者らは、学習データについて理想的な仮定を置いても、少なくしか現れない事実が問題になる理由も説明します。
不確かさを表すよう、モデルが一度も学習されないという意味ではありません。後段の学習で、より信頼できる行動を明示的に促すこともあります。異なる目標と評価が異なる動機を作る、ということです。「AIは知らないと言っても決して報われない」は言いすぎです。
チャットボットのアプリは、ウェブ検索、文書参照、計算機も使えます。こうしたシステムが一切調べないと言うのは不正確です。道具で工程は変わりますが、生成された解釈には、なお確認が要ります。
出会いやすい誤り
架空の町Whiskertonの短い歴史を頼むとしましょう。物語を求めたなら、創作の町長は楽しみの一部です。自治体の記録を求めて「1847年選出のFelix Purrington町長」が出てきたら、同じ創造性が違う部署へ迷い込んでいます。
もっと普通の失敗は、微妙かもしれません。
- 参考文献の形をした創作:立派な題名、もっともらしい著者、雑誌の巻数があっても、実在する論文に対応しません。
- 出典の不一致:実在するリンクでも、そのページが主張を裏づけていません。
- 行きすぎた要約:「提案は審議される」が「提案は承認された」に変わります。
- 細部の混同:二人の人物や二つの製品版の事実を、一つの説明へ混ぜます。
計算や推論の誤りも伴い得ますが、間違った計算をすべてハルシネーションに分類する人ばかりではありません。利用者に役立つ問いは、どの棚に分類するかより、どう検証するかでしょう。
架空の判例をめぐる、実在の事件
Mata対Avianca事件の2023年6月の制裁命令では、弁護士がChatGPT生成の存在しない判例を提出し、真正性を問われても擁護し続けたと裁判所が説明しました。対象者には、共同で5,000ドルの制裁金と、ほかの義務が課されました。
教訓は「チャットボットが間違えた」より広いものです。裁判所が指摘したのは、人間の検証不足と、その後の行動でした。整形された引用を、判決の存在の証拠として扱ってしまったのです。同じ生成器に安心させてもらうのは、判決そのものを探す代わりにはなりません。
何が本当に役立つ?
関連文書を与えると、事実を扱う仕事は改善できます。元の検索拡張生成の研究は、生成と取得した資料を組み合わせ、評価した生成課題で、比較モデルより事実に即した出力を得ました。RAGの解説(英語)で、その考えを紹介しています。
その名前の全システムへの約束ではありません。検索が違う文書や古い記述を選ぶ場合も、モデルが受け取った内容を誤解する場合もあります。根拠は関連し、回答はそれに忠実である必要があります。
日常では、確認を具体的にしましょう。
- 重要な主張を特定する。 遊び心のある見出しと、引用した返品期限では、必要な確認の程度が違います。
- 実際の出典を開く。 著者、日付、該当箇所、その特定の主張を支えるかを見ます。
- 抜き出しと解釈を分ける。 文書が明示することと、推論した結論を尋ねます。
- 数字を独立に確かめる。 説明の段落を受け入れるのではなく、合計を計算し直します。
- 空白を見えるままにする。 「この出典では確認できない」は、きれいに穴を埋める創作より有用です。
プロンプトエンジニアリングのガイド(英語)では、明確な依頼の例を示します。指示は工程の助けであり、間違いを不可能にする命令ではありません。
別のAIは問題を見つけられる?
ときには見つけられます。意味的エントロピーに関する2024年のNature研究は、生成回答の意味のばらつきを調べ、特定の種類のハルシネーションを検出する方法を研究しました。不確実性への研究手法であり、万能の真実検出器ではありません。
読者にとって、食い違う答えは調べる理由です。一致も証明ではありません。同じ誤りを繰り返すことがあるからです。質問の言い換えで不安定さは見えても、根拠なしにはどちらが正しいかわかりません。
新しいモデルならあらゆる課題で必ず誤りが減ると約束したり、この問題は絶対に解けないと断言したりする確かな根拠もありません。使っているアプリと、必要な仕事を評価しましょう。
発想、下書き、驚くほど根気のよい説明を楽しんでください。答えが実在の事実に依存するなら、確かめられるものまで戻りましょう。猫は隅について確信し続けても、あなたは明かりをつけてよいのです。
2026-06-19公開の英語版の記事を日本語に翻訳しました。翻訳日:2026年10月30日。翻訳にはAIを使用し、記事内の時点は原文に合わせています。


